Wie Sie in Antworten von Perplexity AI erscheinen
Wenn Sie wissen möchten, wie Sie in Perplexity-Antworten erscheinen, ist dies der ehrliche Ausgangspunkt: Sie können eine Zitierung nicht erzwingen, aber Sie können eine Website aufbauen, auf die Perplexity zugreifen kann, die es verstehen, der es vertrauen und die es wiederverwenden kann, wenn es eine Frage beantwortet, für die Sie relevant sind. Perplexity ist eine Antwortmaschine. Es durchsucht das Live-Web, generiert eine Antwort und fügt verlinkte Quellen hinzu. Aufzutauchen bedeutet, dass eine Ihrer Seiten ausgewählt wurde, um eine bestimmte Frage zu stützen – nicht, dass Sie im alten Sinne „auf Platz eins gelandet" sind. Der wichtigste technische Hebel ist, dem Such-Crawler von Perplexity Zugang zu Ihren Seiten zu gewähren. Alles andere besteht darin, wirklich nützlich und überprüfbar zu sein, sobald es dort angekommen ist.
Inhaltsverzeichnis
- • Was es tatsächlich bedeutet, in einer Perplexity-Antwort zu erscheinen
- • Wie Perplexity Ihre Seiten findet und abruft
- • Die technische Grundvoraussetzung, die Sie erfüllen müssen
- • Was eine Seite leicht zitierbar macht
- • Gibt es ein Schema oder eine Perplexity-Ranking-Abkürzung?
- • Wie Sie messen, ob es funktioniert
- • Fehler, die Ihre Chancen unbemerkt schmälern
- • Ein Entscheidungsrahmen dafür, wo Sie Aufwand investieren sollten
- • Häufig gestellte Fragen
Was es tatsächlich bedeutet, in einer Perplexity-Antwort zu erscheinen
In einer Perplexity-Antwort zu erscheinen bedeutet in der Regel, dass Perplexity eine Ihrer Seiten als Quelle für eine bestimmte Anfrage ausgewählt hat. Das zeigt sich in mehr als einer Form: eine Zitierung unter der Antwort, eine verlinkte Quelle in einer Rechercheantwort, eine Markennennung innerhalb einer generierten Zusammenfassung, eine Empfehlung für ein Produkt oder eine Dienstleistung oder eine Seite, die zur Überprüfung einer einzelnen Tatsache verwendet wird.
Das ist ein anderes Spiel als traditionelle Rankings. Eine Seite kann die perfekte Quelle für eine Frage sein und für die nächste irrelevant. Sie kann zitiert werden, ohne in herkömmlichen Suchergebnissen an erster Stelle zu stehen, und sie kann gut ranken, aber trotzdem nie in eine Antwort einbezogen werden. Die Frage, um die es bei der Optimierung geht, lautet also nicht „Wie werde ich Nummer eins?" Sie ist enger gefasst und nützlicher: Kann Perplexity meine Seite zuverlässig entdecken, interpretieren und verwenden, wenn es eine Frage beantwortet, für die mein Unternehmen tatsächlich relevant ist?
Diese Neuausrichtung ist wichtig, weil sie verändert, was Sie aufbauen. Sie reichen keine Marke bei einem Verzeichnis ein. Sie erstellen Seiten, die gut als Beleg für die Recherche einer echten Person funktionieren.
Wie Perplexity Ihre Seiten findet und abruft
Die öffentliche Crawler-Dokumentation von Perplexity nennt zwei User-Agents, die sich sehr unterschiedlich verhalten, und das Wissen um diese Aufteilung bewahrt Sie davor, versehentlich die Tür zuzuschlagen.
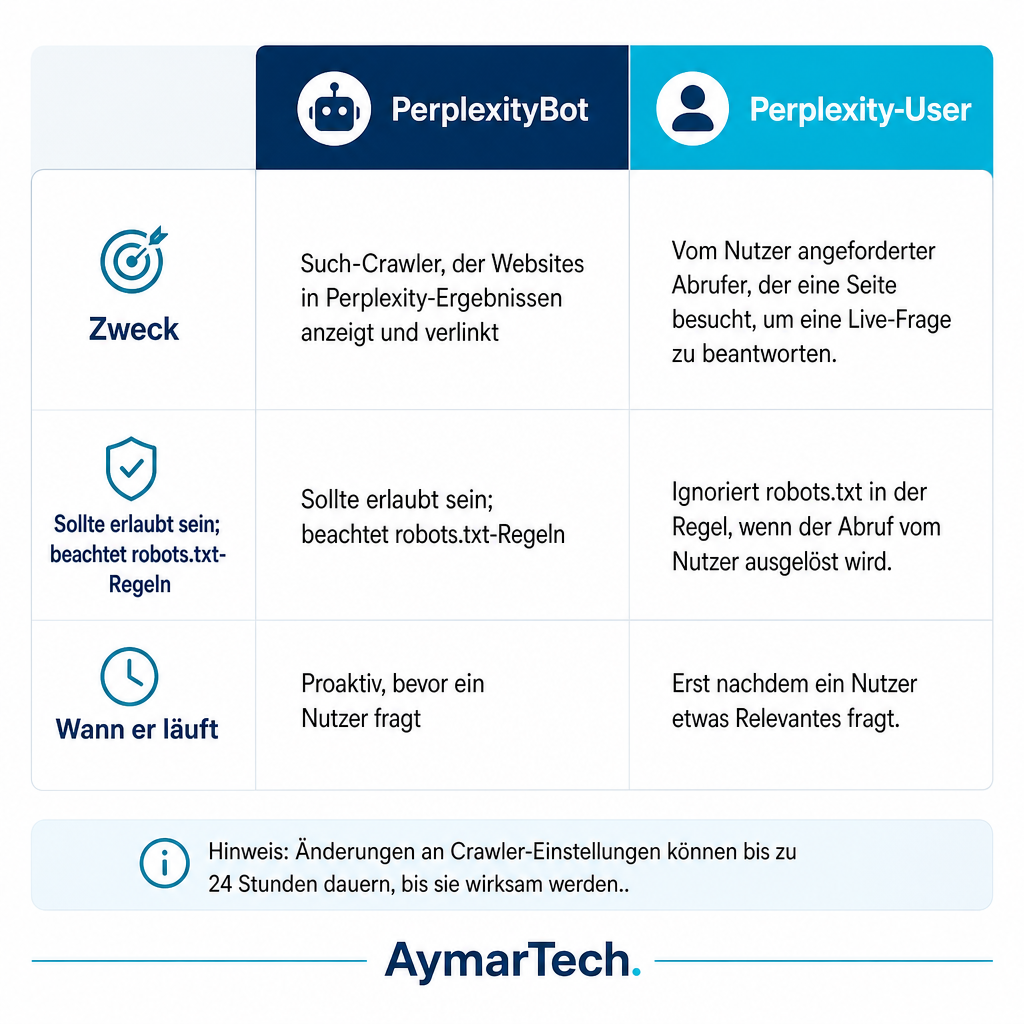
PerplexityBot ist der Such-Crawler, der entwickelt wurde, um Websites in den Perplexity-Suchergebnissen aufzutauchen zu lassen und zu verlinken. Perplexity empfiehlt, ihn in der robots.txt zuzulassen und Anfragen aus seinen veröffentlichten IP-Bereichen zu gestatten. Das ist der Crawler, den Sie auf Ihren Seiten haben wollen, bevor jemand eine Frage stellt, denn so wird Ihr Inhalt überhaupt erst auffindbar. Erwähnenswert: Perplexity gibt an, dass Änderungen an den Crawler-Einstellungen bis zu 24 Stunden dauern können, bis sie sich in seinen Systemen widerspiegeln – beurteilen Sie eine robots.txt-Korrektur also nicht schon innerhalb einer Stunde.
Perplexity-User ist anders. Er unterstützt den benutzergesteuerten Seitenzugriff – wenn jemand Perplexity eine Frage stellt, kann dieser Abrufer eine Seite besuchen, um eine genaue Antwort zu erstellen und auf sie zu verlinken. Perplexity sagt, dass dieser Abrufer robots.txt-Regeln im Allgemeinen ignoriert, wenn der Abruf durch eine Benutzeranfrage ausgelöst wird. Das klingt beruhigend, ist aber keine Strategie. Sich allein auf den benutzergesteuerten Abruf zu verlassen bedeutet, dass Ihre Seite erst dann angeschaut wird, nachdem ein Nutzer bereits etwas Ähnliches genannt hat. Regelmäßiges Crawling durch PerplexityBot gibt Ihnen die Chance, proaktiv aufzutauchen.
Die technische Grundvoraussetzung, die Sie erfüllen müssen
Keiner der Inhaltsratschläge weiter unten in diesem Leitfaden spielt eine Rolle, wenn ein Crawler die Seite nicht laden kann oder der Server einen Fehler zurückgibt. Erfüllen Sie zuerst die Grundvoraussetzung.
Beginnen Sie mit dem Zugriff. Stellen Sie sicher, dass Ihre robots.txt PerplexityBot nicht blockiert. Eine freizügige Regel sieht so aus:
User-agent: PerplexityBot
Allow: /
Fügen Sie das nicht in eine Live-Website ein, ohne den Rest der Datei zu lesen, denn eine restriktivere Regel an anderer Stelle kann sie außer Kraft setzen. Überprüfen Sie dann die Ebene über der robots.txt: Firewalls, Bot-Management-Systeme, CDNs und WAFs lehnen regelmäßig legitime Crawler-Anfragen ab. Perplexity empfiehlt, die User-Agent-Zeichenfolge mit seinen aktuell veröffentlichten IP-Bereichen zu kombinieren, und seine Dokumentation warnt davor, dass sich diese Bereiche ändern können – behandeln Sie daher den offiziellen IP-Endpunkt als die maßgebliche Quelle, nicht eine kopierte Liste, die veraltet.
Zugänglichkeit ist die nächste Hürde. Eine Seite kann nicht zitiert werden, wenn Perplexity den Inhalt nicht erreichen kann. Wichtige Seiten sollten nicht hinter einem Login, einer Bezahlschranke, einem erforderlichen Formular, einer Regionssperre, einer aggressiven Sicherheitsabfrage oder clientseitiger Logik liegen, die den Haupttext verbirgt. Öffentliche Seiten werden nicht automatisch ausgewählt, aber abgeschottete Seiten haben weit weniger Chancen, gefunden zu werden.
Bestätigen Sie dann, dass die Seite einfach funktioniert. Achten Sie für jede wichtige URL auf einen sauberen HTTP 200, kein versehentliches noindex, kein fehlerhaftes Canonical, keine Weiterleitungsketten, keine Serverfehler und kein blockiertes CSS oder JavaScript, das der Artikel zum Rendern benötigt. Die offiziellen technischen Richtlinien von Google beruhen auf derselben Grundlage: Ein Crawler darf nicht blockiert werden, die Seite muss funktionieren und sie muss indexierbaren Inhalt enthalten. Das Erfüllen dieser Bedingungen garantiert keine Sichtbarkeit, aber das Nichterfüllen einer einzigen davon kann eine Seite unbemerkt unberechtigt machen.
Verbinden Sie schließlich Seiten mit gewöhnlichen HTML-internen Links und beschreibendem Ankertext. Eine lokale SEO-Seite, die auf einen Leitfaden zum Google Business-Profil, eine Erläuterung zu Zitaten und eine relevante Service-Seite verlinkt, gibt Crawlern eine klarere Karte und einen Pfad zu unterstützenden Inhalten. Interne Links kaufen keine Zitierungen; sie bauen die Struktur auf, die Ihre Belege auffindbar macht.
Was eine Seite leicht zitierbar macht
Perplexity veröffentlicht keine „Zitierformel", daher ist der zuverlässige Ansatz, Seiten zu schreiben, die gut als Quellen für menschliche Recherche funktionieren. Einige Merkmale leisten die Hauptarbeit.
Beantworten Sie eine konkrete Frage. Ein Titel wie „Marketing-Tipps" ist schwer zu interpretieren; „Wie viel kostet lokales SEO für ein Kleinunternehmen?" signalisiert einen präzisen Bedarf. Stellen Sie dann die Antwort nach oben. Bei einer informativen Seite beginnen Sie mit einer prägnanten Antwort, nennen die Bedingungen oder Ausnahmen, erklären die Begründung, zeigen die Belege und schließen mit der praktischen Konsequenz. Diese Reihenfolge erzeugt auch saubere Passagen, die genau zusammengefasst oder zitiert werden können.
Formulieren Sie Aussagen präzise genug, um sie überprüfen zu können. Vergleichen Sie „KI-Inhalte verbessern SEO" mit „KI-unterstützte Inhalte können ein SEO-Programm unterstützen, wenn die veröffentlichten Seiten originell, nützlich, technisch zugänglich und auf Richtigkeit geprüft sind." Die zweite Aussage definiert die Bedingungen, anstatt ein automatisches Ergebnis zu implizieren. Wo möglich, verankern Sie Aussagen an Daten, Orten, Definitionen, Methodik, Stichprobengrößen, Produktversionen, Preiszeiträumen und Datenquellen.
Zeigen Sie Wissen aus erster Hand. Eine Seite gewinnt Vertrauen, wenn sie etwas hinzufügt, das eine generische Umformulierung nicht kann: Originalforschung, ein dokumentierter Test, Kundenbeobachtungen, ein Prozess, den Sie tatsächlich durchgeführt haben, ein Vergleich mit offengelegten Kriterien oder ein branchenspezifisches Beispiel. Google empfiehlt, hilfreiche, zuverlässige und menschenorientierte Inhalte zu erstellen, und betont, dass einzigartige, nützliche Informationen die Sichtbarkeit in der generativen Suche beeinflussen dürften.
Untermauern Sie die Aussagen, die ein Risiko bergen. Statistiken, rechtliche oder regulatorische Aussagen, medizinische und finanzielle Informationen, Produktspezifikationen, Preise und Leistungsbehauptungen sollten, wo immer möglich, auf eine Primärquelle verlinken. Eine Seite, die Fakten, Interpretation und Meinung trennt, ist leichter zu vertrauen als eine, die alles mit gleicher Gewissheit behauptet. Und halten Sie sie aktuell – Perplexity durchsucht das Live-Web, also überprüfen Sie Seiten, wenn sich Preise, Funktionen, Vorschriften oder Plattformanforderungen ändern, und aktualisieren Sie ein sichtbares Datum nur, wenn die Aktualisierung echt ist.
Noch etwas, das Kleinunternehmen oft übersehen: Produktseiten allein verdienen selten breite Zitierungen. Eine Produktseite erklärt, was Sie verkaufen. Die Fragen, die Menschen stellen, bevor sie kaufbereit sind – welche Option passt zu meiner Situation, wie viel sollte ich einplanen, welche Fehler sollte ich vermeiden – werden durch Kategorie-Leitfäden, ehrliche Vergleiche und problemlösende Inhalte beantwortet. Diese breiteren Seiten schaffen die Übereinstimmungen, die zur Markenentdeckung führen, ohne jeden Absatz in ein Verkaufsgespräch zu verwandeln.
Gibt es ein Schema oder eine Perplexity-Ranking-Abkürzung?
Es gibt die hartnäckige Hoffnung, dass ein spezielles „Perplexity-Schema" oder ein garantiertes Google-Ranking Zitierungen freischaltet. Keines von beiden hält stand.
Es gibt keine Belege für ein dediziertes Schema, das die Aufnahme erzwingt. Strukturierte Daten helfen Suchsystemen, eine Seite zu interpretieren, aber sie ersetzen keinen sichtbaren, nützlichen Inhalt. Google gibt an, dass für seine KI-Funktionen keine zusätzlichen technischen Anforderungen oder besonderen schema.org-Auszeichnungen erforderlich sind und dass das Erfüllen von Anforderungen trotzdem kein Crawling, keine Indexierung oder Auslieferung garantiert. Verwenden Sie herkömmliche Auszeichnungen – Article, Product, Organization, LocalBusiness – nur dann, wenn sie genau beschreiben, was tatsächlich auf der Seite steht. Informationen auszuzeichnen, die nicht sichtbar sind, ist ein Risiko, keine Abkürzung.
Was Google betrifft, ist es für die meisten Unternehmen sinnvoll, dort zuerst zu optimieren, solange „Google zuerst" nicht zu „Nur Google" wird. Antwortmaschinen stützen sich auf auffindbare Webinhalte, und solide Grundlagen machen Ihre Seiten über alle Systeme hinweg auffindbar, crawlbar, indexierbar, organisiert und relevant. Die KI-Such-Richtlinien von Google verweisen auf dieselben Grundlagen: technische Anforderungen erfüllen, Suchrichtlinien befolgen und hilfreiche, menschenorientierte Inhalte erstellen, ohne dass eine spezielle KI-Datei oder Auszeichnung erforderlich ist. Aber ein Google-Ranking berechtigt Sie nicht zu einer Perplexity-Zitierung. Perplexity trifft seine eigenen Abruf- und Zitierentscheidungen. Eine gesunde, nützliche Website gibt Ihnen einfach eine stärkere Grundlage an beiden Orten.
Wenn Sie das parallele Playbook für eine andere Antwortmaschine wünschen, behandelt unser Leitfaden zu wie man in ChatGPT-Antworten erscheint dieselbe Auffindbarkeitslogik für ein anderes System, und unsere Erläuterung zu bewährten Verfahren für KI-zitierbare Inhalte geht tiefer auf die Handwerkskunst auf Seitenebene ein.
Wie Sie messen, ob es funktioniert
Es gibt kein einzelnes Dashboard, das jede Perplexity-Zitierung erfasst, kombinieren Sie daher Signale, anstatt einem zu vertrauen.
Testen Sie manuell. Stellen Sie Perplexity Fragen, die wirklich mit Ihrem Unternehmen zusammenhängen – informative, lokale, vergleichende, problembasierte, produktkategoriebezogene und markenbezogene Varianten. Protokollieren Sie für jeden Test den genauen Prompt, das Datum, ob Ihre Marke erschien, welche URL zitiert wurde, welche anderen Quellen auftauchten und ob sich die Antwort bei einem zweiten Versuch änderte. KI-Antworten variieren, sodass ein einzelner Durchlauf niemals schlüssig ist.
Beobachten Sie die Referral-Analytik. Suchen Sie in der Analytik und in Server-Logs nach Traffic von Perplexity-Domains und verfolgen Sie Sitzungen, Landing-Pages, Engagement, Conversions sowie neue gegenüber wiederkehrenden Besuchern. Das Referral-Volumen kann klein bleiben, selbst wenn eine Seite zitiert wird, denn eine Zitierung kann Bekanntheit aufbauen, ohne einen sofortigen Klick zu erzeugen.
Lesen Sie Ihre Server-Logs. Logs zeigen, ob PerplexityBot tatsächlich Ihre Website erreicht. Gleichen Sie die dokumentierte User-Agent-Zeichenfolge mit den aktuellen offiziellen IP-Bereichen ab – vertrauen Sie nicht der User-Agent-Zeichenfolge allein, da sie gefälscht werden kann.
Vergleichen Sie dann zitierte Seiten im Laufe der Zeit mit nicht zitierten. Welche Themen ziehen Zitierungen an, welche Seiten werden wiederholt herangezogen, ob Seiten mit Originaldaten besser abschneiden als Umformulierungen und ob aktuellere oder besser verlinkte Seiten mehr Aufmerksamkeit erhalten. Diese Muster zeigen Ihnen, wie Sie das System verbessern, anstatt einem einzelnen Prompt nachzujagen.
Fehler, die Ihre Chancen unbemerkt schmälern
Die häufigen Fehler sind nicht dramatisch. Es sind die Art von Fehlern, die gut aussehen, bis Sie die Logs prüfen.
Jeden KI-Crawler zu blockieren ist der große. Allen KI-bezogenen Traffic auszusperren, um den Trainingszugriff zu begrenzen, kann auch Ihre Sichtbarkeit in der Suche entfernen, weil Perplexity seinen Such-Crawler von seinem Foundation-Model-Crawler unterscheidet. Überprüfen Sie die User-Agent-Regeln, bevor Sie breit blockieren. Eng verwandt ist die Annahme, dass Indexierung gleich Zitierung ist – Indexierung macht eine Seite nur für die Entdeckung berechtigt; sie macht sie nicht für jede Frage relevant.
Auf der Inhaltsseite erzeugt das Veröffentlichen generischer KI-Texte im großen Stil keine Autorität. Große Mengen repetitiver, austauschbarer oder ungenauer Seiten untergraben das Vertrauen und schaffen ein Qualitätsrisiko. Die Antwort hinter einem langen Verkaufsgespräch zu verbergen, richtet ähnlichen Schaden an, indem es die Leser dazu bringt, nach dem zu suchen, weswegen sie gekommen sind; beantworten Sie zuerst die Frage, erklären Sie dann, wie Sie helfen. Unbelegte Statistiken sind ein weiteres Glaubwürdigkeitsleck – eine präzise aussehende Zahl ohne Quelle sollte belegt, eingeschränkt oder entfernt werden. Und das Vertrauen auf ein Schema kann Inhalte nicht retten, die dünn, unzugänglich oder irreführend sind.
Der leiseste Fehler ist, garantierte KI-Erwähnungen zu versprechen. Kein verantwortungsvoller Dienst kann garantieren, dass Perplexity eine bestimmte Seite für einen bestimmten Prompt zitiert. Behandeln Sie KI-Sichtbarkeit als ein Ergebnis, das Sie messen, nicht als einen Anspruch, den Sie kaufen.
Ein Entscheidungsrahmen dafür, wo Sie Aufwand investieren sollten
Wenn Sie nicht sicher sind, was Sie als Nächstes beheben sollen, ordnen Sie Ihre Situation der Priorität zu, die sie tatsächlich voranbringt.
| Situation | Beste Priorität |
|---|---|
| Perplexity kann nicht auf die Website zugreifen | robots.txt, WAF, DNS, Statuscodes und Server-Logs überprüfen |
| Seiten sind zugänglich, werden aber selten zitiert | Relevanz, Spezifität, Belege und Struktur verbessern |
| Marke erscheint nur bei markenbezogenen Suchen | Hilfreiche Kategorie-, Vergleichs- und problemlösende Inhalte veröffentlichen |
| Seiten werden zitiert, erhalten aber keine Besuche | Titel, Einleitungen und Landing-Page-Relevanz schärfen |
| Inhalt ist korrekt, aber veraltet | Einen Wartungsprozess hinzufügen und wichtige Fakten aktualisieren |
| Viele Seiten sind nahezu identisch | Überschneidungen zusammenführen und originellen Mehrwert hinzufügen |
| Veröffentlichung ist inkonsistent | Einen nachhaltigen Redaktionskalender aufbauen |
| Dem Team fehlt die Zeit zum Recherchieren und Pflegen | Einen unterstützten Workflow mit menschlicher Überprüfung in Betracht ziehen |
Die letzten beiden Zeilen sind der Ort, an dem ein automatisierter Content-Workflow seinen Platz verdient. Unser Team hat AymarTech genau für diese Lücke gebaut: Wir recherchieren Themen, schreiben und überprüfen Artikel auf Fakten, wenden SEO-Optimierung an, fügen interne Links hinzu, erstellen markengerechte Bilder und veröffentlichen auf Plattformen wie WordPress, Shopify, Webflow, Wix und Notion. Wir unterstützen Inhalte in mehr als 150 Sprachen und können automatisch veröffentlichen, Artikel zur Genehmigung weiterleiten oder sie über eine API oder einen Webhook bereitstellen. Unsere öffentlichen Preise beschreiben einen Plan für 99 $ pro Monat, eine zweitägige Testphase mit zwei Artikeln und eine dreitägige Geld-zurück-Garantie nach der ersten bezahlten Abbuchung – Details, die es wert sind, auf der Live-Website bestätigt zu werden, bevor Sie sich festlegen.
Speziell für Perplexity versprechen wir keine Zitierung, weil das niemand ehrlich kann. Die Verbindung ist operativ: Echtzeit-Recherche hilft, Seiten aktuell zu halten, Faktenprüfung reduziert unbelegte Aussagen, interne Verlinkung verbessert die Entdeckung, konsistente Veröffentlichung erweitert die thematische Abdeckung, CMS-Integrationen verringern die Veröffentlichungsreibung und Genehmigungs-Workflows wahren die menschliche Aufsicht. Wenn Sie lieber das Modell verstehen möchten, bevor es um die Mechanik geht, erklärt unsere Erläuterung zu was Autopilot-SEO eigentlich ist es in einfacher Sprache.
Häufig gestellte Fragen
Wie lange dauert es, bis man in Perplexity-Antworten erscheint?
Es gibt keinen festen Zeitplan. Perplexity sagt, dass Änderungen an den Crawler-Einstellungen bis zu 24 Stunden dauern können, bis sie sich widerspiegeln, aber die tatsächliche Zitier-Sichtbarkeit hängt von Entdeckung, Relevanz, Inhaltsqualität, Anfragennachfrage und den Abrufentscheidungen von Perplexity ab.
Muss ich meine Website bei Perplexity einreichen?
Die Crawler-Dokumentation von Perplexity betont, PerplexityBot zuzulassen und seine Anfragen zu gestatten. Sie beschreibt keinen allgemeinen Einreichungsprozess, der Zitierungen garantiert, daher besteht der praktische Schritt darin, Ihre Seiten zugänglich und nützlich zu machen, anstatt sie „einzureichen".
Zitiert Perplexity nur hochrangige Google-Seiten?
Nein. Google-Sichtbarkeit kann bei Entdeckung und Autorität helfen, aber Perplexity wählt seine eigenen Quellen pro Anfrage aus. Eine Seite sollte für die Frage wirklich nützlich und relevant sein, nicht bloß für eine Ranking-Position optimiert.
Gibt es ein spezielles Schema, das die Aufnahme bei Perplexity garantiert?
Es gibt kein verifiziertes Perplexity-spezifisches Schema, das die Aufnahme erzwingt. Verwenden Sie genaue, herkömmliche strukturierte Daten dort, wo sie mit sichtbaren Inhalten übereinstimmen, aber priorisieren Sie zugängliche, nützliche Seiten.
Können KI-geschriebene Inhalte in Perplexity erscheinen?
Ja, wenn sie zugänglich, relevant, korrekt und nützlich sind. Die Produktionsmethode allein garantiert oder verhindert die Sichtbarkeit nicht. Menschliche Überprüfung ist nach wie vor wichtig für sachliche Aussagen, originelle Erkenntnisse, regulierte Themen und Markengenauigkeit.
Kann irgendjemand Perplexity-Zitierungen garantieren?
Nein. Wir können Recherche, Faktenprüfung, SEO, interne Verlinkung und Veröffentlichungskonsistenz verbessern, aber eine bestimmte Zitierung, Erwähnung, Platzierung oder ein bestimmtes Traffic-Niveau sollte niemals als garantiert betrachtet werden.