Cómo aparecer en las respuestas de Perplexity AI
Si quieres saber cómo aparecer en las respuestas de Perplexity, el punto de partida honesto es este: no puedes forzar una cita, pero sí puedes construir un sitio al que Perplexity pueda acceder, que pueda entender, en el que pueda confiar y que pueda reutilizar cuando responda a una pregunta para la que seas relevante. Perplexity es un motor de respuestas. Busca en la web en vivo, genera una respuesta y adjunta fuentes enlazadas. Aparecer significa que una de tus páginas fue seleccionada para respaldar una pregunta concreta, no que "quedaste en el número uno" en el sentido antiguo. La palanca técnica más importante es permitir que el rastreador de búsqueda de Perplexity llegue a tus páginas. Todo lo demás consiste en ser genuinamente útil y verificable una vez que llega.
Tabla de contenidos
- • Qué significa realmente aparecer en una respuesta de Perplexity
- • Cómo Perplexity encuentra y recupera tus páginas
- • El mínimo técnico que tienes que superar
- • Qué hace que una página sea fácil de citar
- • ¿Existe un schema o un atajo de posicionamiento en Perplexity?
- • Cómo medir si está funcionando
- • Errores que reducen silenciosamente tus posibilidades
- • Un marco de decisión para saber dónde invertir el esfuerzo
- • Preguntas frecuentes
Qué significa realmente aparecer en una respuesta de Perplexity
Aparecer en una respuesta de Perplexity normalmente significa que Perplexity eligió una de tus páginas como fuente para una consulta concreta. Eso se manifiesta de más de una forma: una cita debajo de la respuesta, una fuente enlazada en una respuesta de investigación, una mención de marca dentro de un resumen generado, una recomendación de un producto o servicio, o una página utilizada para verificar un solo dato.
Este es un juego diferente al de los posicionamientos tradicionales. Una página puede ser la fuente perfecta para una pregunta e irrelevante para la siguiente. Puede ser citada sin posicionarse primera en los resultados de búsqueda convencionales, y puede posicionarse bien y aun así no ser utilizada nunca en una respuesta. Así que la pregunta en torno a la que optimizar no es "¿Cómo quedo en el número uno?". Es más concreta y más útil: ¿puede Perplexity descubrir, interpretar y usar mi página de forma fiable cuando responde a una pregunta para la que mi negocio es realmente relevante?
Ese replanteamiento importa porque cambia lo que construyes. No estás enviando una marca a un directorio. Estás produciendo páginas que funcionan bien como evidencia para la investigación de una persona real.
Cómo Perplexity encuentra y recupera tus páginas
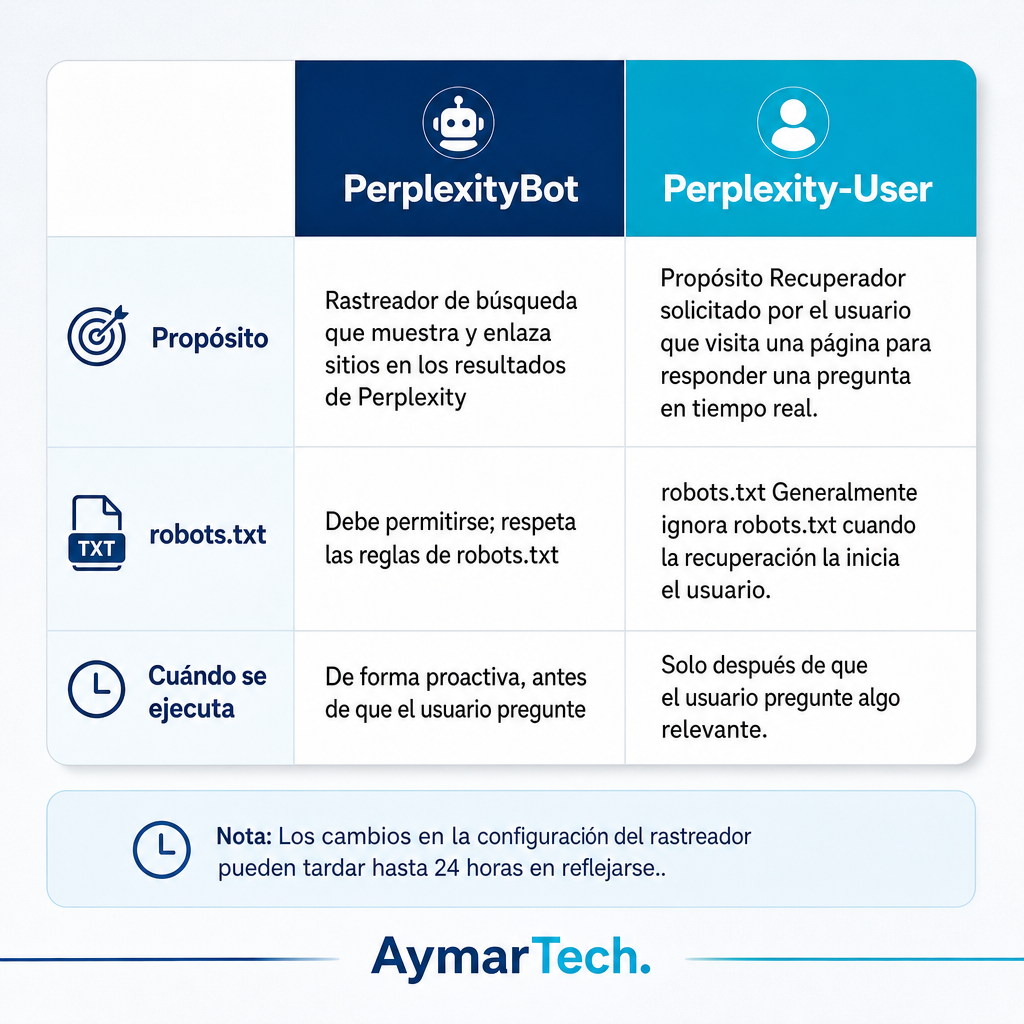
La documentación pública del rastreador de Perplexity nombra dos agentes de usuario que se comportan de forma muy distinta, y conocer esa diferencia evita que cierres la puerta por accidente.
PerplexityBot es el rastreador de búsqueda diseñado para mostrar y enlazar sitios web en los resultados de búsqueda de Perplexity. Perplexity recomienda permitirlo en robots.txt y autorizar las solicitudes desde sus rangos de IP publicados. Este es el rastreador que quieres que llegue a tus páginas antes de que nadie haga una pregunta, porque es la forma en que tu contenido se vuelve descubrible en primer lugar. Vale la pena señalar: Perplexity indica que los cambios en la configuración del rastreador pueden tardar hasta 24 horas en reflejarse en sus sistemas, así que no juzgues un arreglo de robots.txt en una hora.
Perplexity-User es distinto. Admite el acceso a páginas solicitado por el usuario: cuando alguien le hace una pregunta a Perplexity, este recuperador puede visitar una página para ayudar a producir una respuesta precisa y enlazarla. Perplexity dice que este recuperador generalmente ignora las reglas de robots.txt cuando la recuperación es activada por una solicitud del usuario. Eso suena tranquilizador, pero no es una estrategia. Depender únicamente de la recuperación solicitada por el usuario significa que tu página solo recibe atención después de que un usuario ya nombró algo parecido a ella. El rastreo regular por parte de PerplexityBot te da la oportunidad de aparecer de forma proactiva.
El mínimo técnico que tienes que superar
Ninguno de los consejos de contenido que aparecen más adelante en esta guía importa si un rastreador no puede cargar la página o el servidor devuelve un error. Supera primero el mínimo.
Empieza por el acceso. Confirma que tu robots.txt no bloquea a PerplexityBot. Una regla permisiva se ve así:
User-agent: PerplexityBot
Allow: /
No pegues eso en un sitio en vivo sin leer el resto del archivo, porque una regla más restrictiva en otro lugar puede anularla. Luego revisa la capa por encima de robots.txt: los firewalls, los sistemas de gestión de bots, las CDN y los WAF rechazan con frecuencia solicitudes legítimas de rastreadores. Perplexity recomienda combinar la cadena del agente de usuario con sus rangos de IP publicados actuales, y su documentación advierte que esos rangos pueden cambiar, así que trata el endpoint oficial de IP como la fuente de verdad, no una lista copiada que queda desactualizada.
La accesibilidad es la siguiente barrera. Una página no puede ser citada si Perplexity no puede acceder al contenido. Las páginas importantes no deberían estar detrás de un inicio de sesión, un muro de pago, el envío obligatorio de un formulario, un bloqueo regional, un desafío de seguridad agresivo o lógica del lado del cliente que oculte el texto principal. Las páginas públicas no se eligen automáticamente, pero las que están restringidas tienen muchas menos posibilidades de ser encontradas.
Después confirma que la página simplemente funciona. Para cada URL importante, busca un HTTP 200 limpio, sin un noindex accidental, sin un canonical roto, sin cadenas de redirecciones, sin errores de servidor y sin CSS o JavaScript bloqueado que el artículo necesite para renderizar. La guía técnica oficial de Google se apoya en la misma base: un rastreador no debe estar bloqueado, la página debe funcionar y debe contener contenido indexable. Cumplir esas condiciones no garantiza visibilidad, pero fallar en cualquiera de ellas puede dejar silenciosamente a una página sin posibilidad de ser elegida.
Por último, conecta las páginas con enlaces internos HTML normales y texto de anclaje descriptivo. Una página de SEO local que enlaza a una guía de Perfil de Empresa en Google, una explicación sobre citaciones y una página de servicio relevante le da a los rastreadores un mapa más claro y un camino hacia el contenido de apoyo. Los enlaces internos no compran citas; construyen la estructura que hace que tu evidencia sea encontrable.
Qué hace que una página sea fácil de citar
Perplexity no publica una "fórmula de citación", así que la jugada fiable es escribir páginas que funcionen bien como fuentes para la investigación humana. Unas pocas características hacen el trabajo pesado.
Responde una pregunta específica. Un título como "Consejos de marketing" es difícil de interpretar; "¿Cuánto cuesta el SEO local para una pequeña empresa?" señala una necesidad precisa. Luego pon la respuesta cerca de la parte superior. Para una página informativa, comienza con una respuesta concisa, nombra las condiciones o excepciones, explica el razonamiento, muestra la evidencia y cierra con la implicación práctica. Ese orden también produce pasajes limpios que pueden resumirse o citarse con precisión.
Haz afirmaciones lo bastante precisas como para poder verificarlas. Compara "El contenido con IA mejora el SEO" con "El contenido asistido por IA puede respaldar un programa de SEO cuando las páginas publicadas son originales, útiles, técnicamente accesibles y revisadas en cuanto a precisión". La segunda define las condiciones en lugar de implicar un resultado automático. Cuando puedas, ancla las afirmaciones a fechas, ubicaciones, definiciones, metodología, tamaños de muestra, versiones de producto, períodos de precios y fuentes de datos.
Muestra conocimiento de primera mano. Una página gana confianza cuando añade algo que una reescritura genérica no puede: investigación original, una prueba documentada, observaciones de clientes, un proceso que realmente ejecutaste, una comparación con criterios divulgados o un ejemplo específico del sector. Google recomienda crear contenido útil, fiable y centrado en las personas, y enfatiza que la información única y útil probablemente influya en la visibilidad en la búsqueda generativa.
Respalda las afirmaciones que conllevan riesgo. Las estadísticas, las declaraciones legales o regulatorias, la información médica y financiera, las especificaciones de producto, los precios y las afirmaciones de rendimiento deberían enlazar a una fuente primaria siempre que sea posible. Una página que separa hecho, interpretación y opinión es más fácil de creer que una que afirma todo con igual certeza. Y mantenla actualizada: Perplexity busca en la web en vivo, así que revisa las páginas cuando cambien precios, características, regulaciones o requisitos de plataforma, y actualiza una fecha visible solo cuando la actualización sea real.
Una cosa más que las pequeñas empresas suelen pasar por alto: las páginas de producto por sí solas rara vez obtienen citas amplias. Una página de producto explica qué vendes. Las preguntas que la gente hace antes de estar lista para comprar —qué opción se ajusta a mi situación, qué presupuesto debería prever, qué errores debería evitar— se responden con guías de categoría, comparaciones honestas y contenido de resolución de problemas. Esas páginas más amplias crean las coincidencias que conducen al descubrimiento de la marca sin convertir cada párrafo en un argumento de venta.
¿Existe un schema o un atajo de posicionamiento en Perplexity?
Hay una esperanza persistente de que un "schema especial de Perplexity" o un posicionamiento garantizado en Google desbloqueen las citas. Ninguna de las dos se sostiene.
Ninguna evidencia respalda un schema dedicado que fuerce la inclusión. Los datos estructurados ayudan a los sistemas de búsqueda a interpretar una página, pero no reemplazan el contenido visible y útil. Google indica que no hay requisitos técnicos adicionales ni marcado especial de schema.org necesario para sus funciones de IA, y que cumplir los requisitos sigue sin garantizar el rastreo, la indexación o el servicio. Usa marcado convencional —Article, Product, Organization, LocalBusiness— solo cuando describa con precisión lo que realmente hay en la página. Marcar información que no es visible es un riesgo, no un atajo.
En cuanto a Google, optimizar allí primero es sensato para la mayoría de las empresas, siempre que "Google primero" no se convierta en "Google únicamente". Los motores de respuestas se apoyan en contenido web descubrible, y unos fundamentos sólidos hacen que tus páginas sean encontrables, rastreables, indexables, organizadas y relevantes en todos los sistemas. La guía de búsqueda con IA de Google apunta a los mismos básicos: cumple los requisitos técnicos, sigue las políticas de búsqueda y crea contenido útil centrado en las personas, sin necesidad de un archivo o marcado especial de IA. Pero un posicionamiento en Google no te da derecho a una cita en Perplexity. Perplexity toma sus propias decisiones de recuperación y de citación. Un sitio sano y útil simplemente te da una base más fuerte en ambos lugares.
Si quieres el manual paralelo para un motor de respuestas distinto, nuestra guía sobre cómo aparecer en las respuestas de ChatGPT cubre la misma lógica de descubribilidad para un sistema diferente, y nuestra explicación sobre buenas prácticas para contenidos citables por IA profundiza en el oficio a nivel de página.
Cómo medir si está funcionando
No existe un único panel que capture cada cita de Perplexity, así que combina señales en lugar de confiar en una sola.
Prueba manualmente. Haz a Perplexity preguntas que se relacionen genuinamente con tu negocio: variaciones informativas, locales, de comparación, basadas en problemas, de categoría de producto y de marca. Para cada prueba, registra el prompt exacto, la fecha, si apareció tu marca, qué URL se citó, qué otras fuentes aparecieron y si la respuesta cambió en un segundo intento. Las respuestas de IA varían, así que una sola ejecución nunca es concluyente.
Observa la analítica de referidos. Busca tráfico procedente de dominios de Perplexity en la analítica y los registros del servidor, y rastrea las sesiones, las páginas de destino, el engagement, las conversiones y los visitantes nuevos frente a recurrentes. El volumen de referidos puede seguir siendo pequeño incluso cuando una página es citada, porque una cita puede generar reconocimiento sin producir un clic inmediato.
Lee los registros de tu servidor. Los registros revelan si PerplexityBot está realmente llegando a tu sitio. Coteja la cadena del agente de usuario documentada con los rangos de IP oficiales actuales; no confíes solo en la cadena del agente de usuario, ya que puede falsificarse.
Luego compara las páginas citadas con las no citadas a lo largo del tiempo. Qué temas atraen citas, qué páginas se usan repetidamente, si las páginas con datos originales superan a las reescrituras, y si las páginas recientes o mejor enlazadas reciben más atención. Esos patrones te indican cómo mejorar el sistema en lugar de perseguir un solo prompt.
Errores que reducen silenciosamente tus posibilidades
Los fallos comunes no son dramáticos. Son del tipo que parece estar bien hasta que revisas los registros.
Bloquear todos los rastreadores de IA es el principal. Cerrar el paso a todo el tráfico relacionado con la IA para limitar el acceso al entrenamiento también puede eliminar tu visibilidad en la búsqueda, porque Perplexity distingue su rastreador de búsqueda de su rastreador del modelo de base. Revisa las reglas del agente de usuario antes de bloquear de forma amplia. Estrechamente relacionado está suponer que la indexación equivale a la citación: la indexación solo hace que una página sea elegible para el descubrimiento; no la hace relevante para cada pregunta.
En el lado del contenido, publicar texto genérico de IA a gran escala no fabrica autoridad. Grandes volúmenes de páginas repetitivas, intercambiables o inexactas erosionan la confianza y crean riesgo de calidad. Ocultar la respuesta detrás de un largo argumento de venta hace un daño similar al obligar a los lectores a buscar aquello por lo que vinieron; responde la pregunta primero y luego explica cómo ayudas. Las estadísticas sin respaldo son otra fuga de credibilidad: un número que parece preciso sin una fuente debería tener fuente, matizarse o eliminarse. Y apoyarse en el schema no puede rescatar contenido que es pobre, inaccesible o engañoso.
El error más silencioso es prometer menciones de IA garantizadas. Ningún servicio responsable puede garantizar que Perplexity citará una página específica para un prompt específico. Trata la visibilidad en IA como un resultado que mides, no como un derecho que compras.
Un marco de decisión para saber dónde invertir el esfuerzo
Cuando no estés seguro de qué arreglar a continuación, haz coincidir tu situación con la prioridad que realmente la mueve.
| Situación | Mejor prioridad |
|---|---|
| Perplexity no puede acceder al sitio | Revisa robots.txt, WAF, DNS, códigos de estado y registros del servidor |
| Las páginas son accesibles pero rara vez se citan | Mejora la relevancia, la especificidad, la evidencia y la estructura |
| La marca aparece solo en búsquedas de marca | Publica contenido útil de categoría, comparación y resolución de problemas |
| Las páginas se citan pero no reciben visitas | Afina los títulos, las introducciones y la relevancia de las páginas de destino |
| El contenido es preciso pero está desactualizado | Añade un proceso de mantenimiento y actualiza los datos clave |
| Muchas páginas son casi idénticas | Consolida las coincidencias y añade valor original |
| La publicación es inconsistente | Construye un calendario editorial sostenible |
| Al equipo le falta tiempo para investigar y mantener | Considera un flujo de trabajo asistido con revisión humana |
Las dos últimas filas son donde un flujo de trabajo de contenido automatizado se gana su lugar. Nuestro equipo construyó AymarTech precisamente para esa brecha: investigamos temas, escribimos y verificamos artículos, aplicamos optimización SEO, añadimos enlaces internos, creamos imágenes acordes con la marca y publicamos en plataformas como WordPress, Shopify, Webflow, Wix y Notion. Damos soporte a contenido en más de 150 idiomas y podemos publicar automáticamente, enviar artículos para aprobación o entregarlos mediante una API o un webhook. Nuestros precios públicos describen un plan de 99 $ al mes, una prueba de dos artículos durante dos días y una garantía de devolución de dinero de tres días tras el primer cargo pagado; conviene confirmar los detalles en el sitio en vivo antes de comprometerte.
Para Perplexity en concreto, no prometemos una cita, porque nadie honestamente puede. La conexión es operativa: la investigación en tiempo real ayuda a mantener las páginas actualizadas, la verificación de datos reduce las afirmaciones sin respaldo, el enlazado interno mejora el descubrimiento, la publicación constante amplía la cobertura temática, las integraciones con el CMS reducen la fricción al publicar y los flujos de aprobación preservan la supervisión humana. Si prefieres entender el modelo antes que la mecánica, nuestra explicación sobre qué es realmente el SEO en piloto automático lo expone en lenguaje sencillo.
Preguntas frecuentes
¿Cuánto tiempo tarda en aparecer en las respuestas de Perplexity?
No hay un calendario fijo. Perplexity dice que los cambios en la configuración del rastreador pueden tardar hasta 24 horas en reflejarse, pero la visibilidad real de las citas depende del descubrimiento, la relevancia, la calidad del contenido, la demanda de consultas y las decisiones de recuperación de Perplexity.
¿Necesito enviar mi sitio web a Perplexity?
La documentación del rastreador de Perplexity enfatiza permitir a PerplexityBot y autorizar sus solicitudes. No describe un proceso general de envío que garantice citas, así que la jugada práctica es hacer que tus páginas sean accesibles y útiles en lugar de "enviarlas".
¿Perplexity solo cita páginas de Google bien posicionadas?
No. La visibilidad en Google puede ayudar al descubrimiento y a la autoridad, pero Perplexity selecciona sus propias fuentes por consulta. Una página debería ser genuinamente útil y relevante para la pregunta, no meramente optimizada para una posición de ranking.
¿Existe un schema especial que garantice la inclusión en Perplexity?
No hay ningún schema específico de Perplexity verificado que fuerce la inclusión. Usa datos estructurados precisos y convencionales donde coincidan con el contenido visible, pero prioriza páginas accesibles y útiles.
¿Puede el contenido escrito por IA aparecer en Perplexity?
Sí, si es accesible, relevante, preciso y útil. El método de producción por sí solo ni garantiza ni impide la visibilidad. La revisión humana sigue importando para las afirmaciones factuales, las ideas originales, los temas regulados y la precisión de la marca.
¿Alguien puede garantizar citas en Perplexity?
No. Podemos mejorar la investigación, la verificación de datos, el SEO, el enlazado interno y la constancia en la publicación, pero una cita, mención, posicionamiento o nivel de tráfico específico nunca debería tratarse como garantizado.